IA et cartes graphiques : de la RTX 3090 à Rubin, ce qui a vraiment changé
Depuis 2020, les cartes graphiques sont devenues le moteur de l’intelligence artificielle. NVIDIA domine, AMD rattrape son retard, et les prix s’envolent. Derrière les annonces, un seul chiffre explique presque tout : la mémoire. Voici comment s’y retrouver, et quelle carte choisir selon que l’IA tourne dans votre bureau ou dans un datacenter.
Pourquoi une carte graphique pour faire de l’IA ?
Un modèle d’IA comme ChatGPT ou Llama, c’est une énorme liste de nombres, les « paramètres », à multiplier entre eux des milliards de fois. Un processeur classique fait ces calculs un par un. Une carte graphique en fait des milliers en parallèle : elle a été conçue pour calculer les pixels d’un jeu vidéo, et ce sont exactement les mêmes opérations.
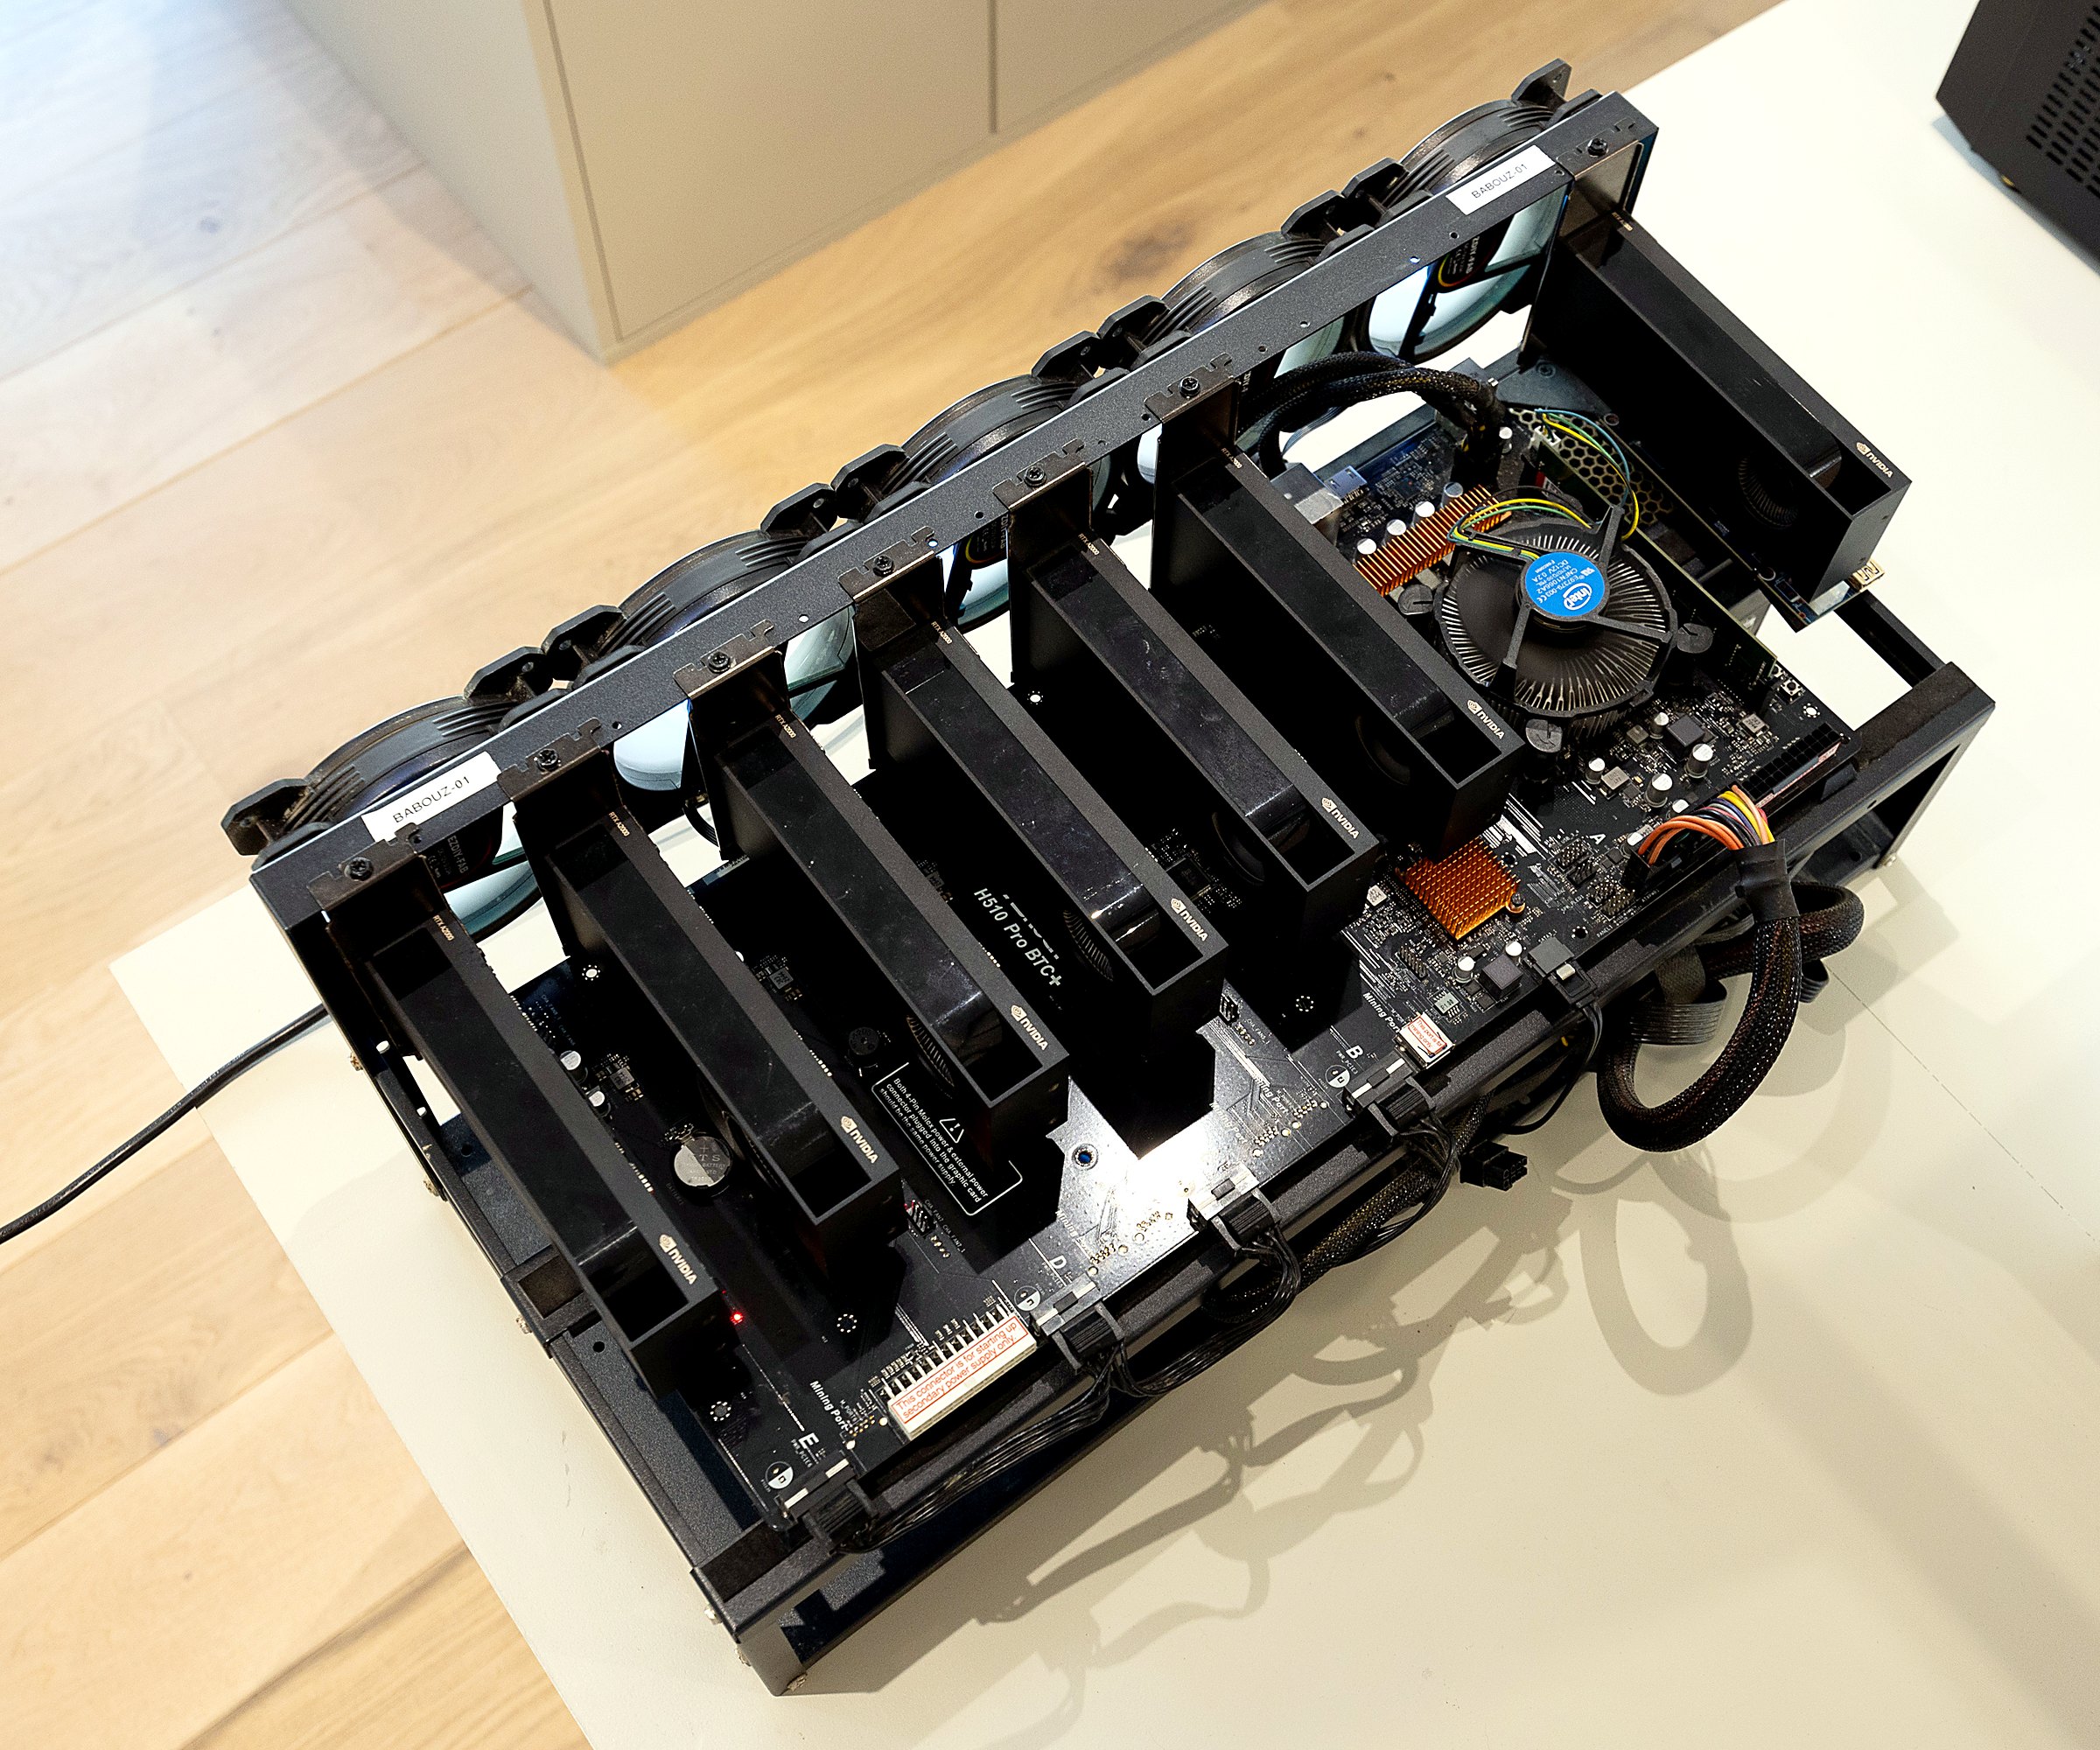
Chez MDM Informatique, nous l’avons appris sur le terrain : au début des années 2020, nous avons exploité pendant trois ans un parc de 700 cartes NVIDIA RTX en calcul parallèle. C’est cette expérience qui nous sert aujourd’hui à dimensionner les serveurs IA de nos clients.
Le chiffre qui compte vraiment : la mémoire
Les fabricants mettent en avant des « pétaFLOPS », c’est-à-dire la puissance de calcul brute. Pour faire tourner une IA au quotidien, deux autres chiffres comptent davantage.
La capacité mémoire, en Go, décide si le modèle rentre. Un modèle de 32 milliards de paramètres compressé en 4 bits pèse environ 18 à 20 Go. S’il ne tient pas dans la mémoire de la carte, il déborde vers la mémoire du PC et devient dix fois plus lent.
La bande passante mémoire, en Go/s, décide de la vitesse. L’IA fonctionne en deux temps. Elle lit d’abord votre question : cette phase dépend surtout de la puissance de calcul. Elle écrit ensuite la réponse mot par mot : cette phase dépend surtout de la vitesse de la mémoire, car pour chaque mot la carte relit tout le modèle.
Exemple avec un modèle de 19 Go :
- RTX 5090 (1 792 Go/s) : environ 94 mots par seconde au maximum ;
- Radeon AI PRO R9700 (640 Go/s) : environ 34 mots par seconde ;
- mini-PC DGX Spark (273 Go/s) : environ 14 mots par seconde.
C’est un plafond théorique : en pratique on obtient un peu moins, mais le classement est toujours respecté.
Deux familles de mémoire : GDDR et HBM
- GDDR (GDDR6, GDDR6X, GDDR7) : des puces mémoire soudées autour du processeur graphique, sur la carte. C’est la mémoire des cartes grand public et professionnelles : abordable, mais limitée à 96 Go au mieux aujourd’hui.
- HBM (HBM2, HBM3, HBM3e, HBM4) : des piles de mémoire empilées directement contre la puce, dans le même boîtier. Beaucoup plus rapide et plus dense, beaucoup plus chère, elle est réservée aux accélérateurs de datacenter.
- Mémoire unifiée (LPDDR5X) : une seule grande mémoire partagée entre le processeur et le GPU, comme sur les Mac ou les nouveaux mini-PC IA. Énorme capacité (128 Go), vitesse modeste.
Notre indice de performance mémoire
Pour comparer des cartes très différentes, nous utilisons un indice simple : la bande passante mémoire, avec la RTX 3090 de 2020 comme base 100. Un indice de 200 signifie que la carte écrit, en théorie, deux fois plus vite qu’une RTX 3090 sur un modèle qui tient dans sa mémoire.
Cartes pour une utilisation locale (poste, serveur d’entreprise)
| Année | Carte | Marque | Mémoire | Bande passante | Indice |
|---|---|---|---|---|---|
| 2020 | GeForce RTX 3090 | NVIDIA | 24 Go GDDR6X | 936 Go/s | 100 |
| 2020 | Radeon RX 6900 XT | AMD | 16 Go GDDR6 | 512 Go/s | 55 |
| 2020 | RTX A6000 (pro) | NVIDIA | 48 Go GDDR6 | 768 Go/s | 82 |
| 2022 | GeForce RTX 4090 | NVIDIA | 24 Go GDDR6X | 1 008 Go/s | 108 |
| 2022 | Radeon RX 7900 XTX | AMD | 24 Go GDDR6 | 960 Go/s | 103 |
| 2022 | RTX 6000 Ada (pro) | NVIDIA | 48 Go GDDR6 | 960 Go/s | 103 |
| 2023 | Radeon PRO W7900 (pro) | AMD | 48 Go GDDR6 | 864 Go/s | 92 |
| 2025 | GeForce RTX 5090 | NVIDIA | 32 Go GDDR7 | 1 792 Go/s | 191 |
| 2025 | Radeon RX 9070 XT | AMD | 16 Go GDDR6 | 644 Go/s | 69 |
| 2025 | Radeon AI PRO R9700 (pro) | AMD | 32 Go GDDR6 | 640 Go/s | 68 |
| 2025 | RTX PRO 6000 Blackwell (pro) | NVIDIA | 96 Go GDDR7 | 1 792 Go/s | 191 |
| 2025 | DGX Spark (mini-PC) | NVIDIA | 128 Go unifiée | 273 Go/s | 29 |
| 2025 | Ryzen AI Max+ 395 (mini-PC) | AMD | 128 Go unifiée | 256 à 273 Go/s | 27 à 29 |
Accélérateurs de datacenter
| Année | Accélérateur | Marque | Mémoire | Bande passante | Indice |
|---|---|---|---|---|---|
| 2020 | A100 80 Go | NVIDIA | 80 Go HBM2e | 2 039 Go/s | 218 |
| 2020 | Instinct MI100 | AMD | 32 Go HBM2 | 1 229 Go/s | 131 |
| 2021 | Instinct MI250X | AMD | 128 Go HBM2e | 3 277 Go/s | 350 |
| 2022 | H100 SXM | NVIDIA | 80 Go HBM3 | 3 350 Go/s | 358 |
| 2023 | Instinct MI300X | AMD | 192 Go HBM3 | 5 300 Go/s | 566 |
| 2024 | H200 | NVIDIA | 141 Go HBM3e | 4 800 Go/s | 513 |
| 2024 | Instinct MI325X | AMD | 256 Go HBM3e | 6 000 Go/s | 641 |
| 2025 | B200 | NVIDIA | 192 Go HBM3e | 8 000 Go/s | 855 |
| 2025 | B300 (Blackwell Ultra) | NVIDIA | 288 Go HBM3e | 8 000 Go/s | 855 |
| 2025 | Instinct MI355X | AMD | 288 Go HBM3e | 8 000 Go/s | 855 |
| 2026 | Rubin | NVIDIA | 288 Go HBM4 | 20 000 à 22 000 Go/s | ≈ 2 250 |
| 2026 | Instinct MI455X | AMD | 432 Go HBM4 | 23 300 Go/s | ≈ 2 490 |
La puissance de calcul depuis 2020 : ×160 en six ans
La puissance d’une carte IA se mesure en TFLOPS, c’est-à-dire en milliers de milliards d’opérations par seconde. Le graphique utilise une échelle logarithmique : chaque ligne horizontale représente une puissance dix fois plus grande que la précédente. Les valeurs sont celles annoncées par les constructeurs, par carte.
Comment lire ce graphique. Chez NVIDIA en datacenter, on passe de 312 TFLOPS (A100, 2020) à 50 000 TFLOPS (Rubin, 2026) : 160 fois plus en six ans, là où la loi de Moore classique ne promettait qu’un facteur 8. AMD suit une trajectoire très proche, avec un léger décalage : 10 100 TFLOPS en 4 bits pour la MI355X, puis 40 000 pour la MI455X.
Attention au piège : une grande partie de ce gain vient de la baisse de précision. Un calcul en 4 bits coûte environ quatre fois moins cher qu’en 16 bits. L’A100 calculait en 16 bits, la H100 en 8 bits, Blackwell en 4 bits. À précision égale (FP16), le gain réel entre l’A100 et la B200 est d’environ ×7, pas ×30. Et on ne descendra pas beaucoup plus bas que 4 bits sans dégrader les réponses : ce levier s’épuise.
Les cartes de bureau progressent aussi, mais moins vite : environ ×12 entre la RTX 3090 et la RTX 5090, là encore en partie grâce au passage en 4 bits.
Le vrai frein : la mémoire ne suit pas
Ce second graphique compare, chez NVIDIA en datacenter, la croissance de la puissance de calcul et celle de la bande passante mémoire, avec l’A100 de 2020 comme base 1.
C’est ce qu’on appelle le « mur de la mémoire ». Depuis 2020, le calcul a été multiplié par 160 et la bande passante seulement par 11. Les puces savent calculer bien plus vite qu’on ne peut les alimenter en données. Or c’est la mémoire qui fixe la vitesse à laquelle une IA écrit sa réponse. Voilà pourquoi toutes les annonces de 2026 parlent d’abord de mémoire.
NVIDIA : l’histoire d’une domination (2020-2026)
- 2020, Ampere (A100, RTX 3090). Arrivée des cœurs Tensor de troisième génération. L’A100 devient la carte de référence des laboratoires d’IA ; la RTX 3090 et ses 24 Go deviennent la carte des passionnés et des développeurs.
- 2022, Hopper (H100) et Ada (RTX 4090). La H100 introduit un moteur dédié aux « Transformers », l’architecture de ChatGPT, qui calcule en précision réduite (FP8) pour aller deux fois plus vite. Elle devient la carte la plus convoitée du monde.
- 2024-2025, Blackwell (B200, B300, RTX 5090, RTX PRO 6000). Deux puces réunies en une seule, un calcul en 4 bits (FP4) et, côté bureau, l’arrivée de la mémoire GDDR7. La RTX PRO 6000 et ses 96 Go deviennent la carte locale la plus puissante du marché.
- 2026, Vera Rubin. Passage à la mémoire HBM4, qui triple presque la bande passante. Chaque GPU consomme environ 2 kW et doit être refroidi par liquide. NVIDIA ne vend plus des cartes, mais des armoires entières de 72 GPU.
La vraie force de NVIDIA, c’est CUDA. Ce langage de programmation, lancé en 2007, est devenu le standard de l’IA : presque tous les logiciels sont d’abord écrits et optimisés pour lui.
AMD : le challenger qui mise sur la mémoire
- 2020, CDNA et MI100. AMD sépare ses cartes de jeu (RDNA) de ses accélérateurs de calcul (CDNA).
- 2021-2022, MI250X. Elle équipe Frontier, le premier supercalculateur exaflopique au monde.
- 2023-2025, MI300X, MI325X puis MI355X. AMD prend l’avantage sur la capacité mémoire : un modèle qui demande deux GPU NVIDIA peut tenir sur un seul GPU AMD.
- 2026, MI455X et l’armoire Helios. 432 Go de HBM4 par GPU, 72 GPU par armoire, en réponse directe à Rubin.
- Côté local : RX 7900 XTX, RX 9070 XT, Radeon AI PRO R9700 et Ryzen AI Max+ 395. Moins rapides, mais beaucoup moins chères à mémoire égale : la R9700 offre 32 Go pour environ le tiers du prix d’une RTX 5090.
Le talon d’Achille d’AMD, c’est le logiciel (ROCm). Il a longtemps été le frein principal. Début 2026, les cartes RDNA 4 ont enfin obtenu un support officiel sous Linux et Windows, mais la lecture de la question reste nettement plus lente que chez NVIDIA et certains outils demandent encore des réglages.
Quelle carte pour quel usage ?
Pour l’IA locale, dans votre entreprise
- Cartes grand public (RTX 5090, RTX 4090, RX 9070 XT). Pour les tests, un poste de développement ou une petite structure avec un ou deux utilisateurs. Le meilleur rapport vitesse / prix, mais pas de mémoire ECC (qui corrige les erreurs), un refroidissement pensé pour un PC de jeu et 32 Go au maximum.
- Cartes professionnelles (RTX PRO 6000, Radeon AI PRO R9700, W7900). Pour un serveur IA installé chez vous et partagé par toute l’équipe : plus de mémoire, format adapté aux serveurs, pilotes certifiés, garantie professionnelle. La RTX PRO 6000 pour la vitesse et les gros modèles sur une seule carte ; deux R9700 (64 Go au total) pour un budget maîtrisé, à condition que les logiciels sachent répartir le modèle sur les deux cartes.
- Mini-PC à mémoire unifiée (DGX Spark, Ryzen AI Max+ 395). Pour prototyper et essayer de très gros modèles dans un boîtier silencieux et compact. Trop lents pour servir plusieurs utilisateurs en même temps.
Pour le datacenter
- H100, H200, B200, B300, Rubin, Instinct MI300X à MI455X. Pour l’entraînement de modèles et les services d’IA à grande échelle. Mémoire HBM, liaisons ultra-rapides entre GPU (NVLink, Infinity Fabric), 1 à 2,3 kW par GPU, refroidissement liquide. Ils se vendent désormais à l’armoire, pour plusieurs millions d’euros.
- Pour une PME, ce n’est pas un achat réaliste. On y accède en location chez un hébergeur, avec la question de la souveraineté des données.
Où va-t-on ?
- La mémoire devient la priorité. Les constructeurs mettent désormais en avant la mémoire et les liaisons entre GPU plutôt que la puissance brute. La prochaine étape, la HBM4E, vise jusqu’à 4 To/s par pile.
- La pénurie de mémoire devient un risque réel. Pour Rubin Ultra en 2027, NVIDIA pourrait descendre à 192 Go de mémoire, un tiers de moins que Rubin, faute de DRAM disponible. La même tension fait monter le prix des cartes de bureau.
- Des puces spécialisées dans la rédaction des réponses. NVIDIA associe désormais à Rubin une armoire dédiée (Groq 3 LPX) dont les puces embarquent leur propre mémoire ultra-rapide. On sépare « lire la question » et « écrire la réponse » sur des matériels différents.
- L’énergie et le refroidissement liquide deviennent incontournables. Avec près de 2 kW par GPU, un datacenter IA ressemble désormais à une infrastructure électrique lourde.
- Un rythme annuel. AMD annonce la famille MI500 pour 2027 et la MI600 pour 2028 ; NVIDIA suit la même cadence.
- Des modèles plus économes, une bonne nouvelle pour le local. Les modèles dits « MoE » (mélange d’experts) n’activent qu’une partie de leurs paramètres à chaque mot et répondent plusieurs fois plus vite à taille égale. À matériel égal, votre serveur fait tourner des IA de plus en plus capables.
Et pour votre entreprise, concrètement ?
Pour une TPE ou une PME jusqu’à 50 personnes, l’objectif n’est pas d’avoir la carte la plus puissante du monde. L’objectif est un serveur qui fait tourner un bon modèle de 20 à 70 milliards de paramètres, assez vite pour que personne n’attende, et sans que vos données quittent vos locaux.
Dans la pratique, nous assemblons une ou deux RTX 5090 pour un premier assistant IA, une RTX PRO 6000 quand plusieurs services l’utilisent en même temps, ou des Radeon AI PRO R9700 quand le budget prime et que les usages le permettent. Un conseil : la hausse du prix de la mémoire tire tous les prix vers le haut depuis 2025. Mieux vaut dimensionner juste, à partir de vos vrais usages, que surdimensionner par précaution.
C’est précisément le rôle de notre audit sur site
Nous identifions ce que vous voulez automatiser, puis nous choisissons le matériel qui y répond, ni plus, ni moins. Audit sur site à partir de 699 € HT.
À lire aussi
Sources
Caractéristiques issues des fiches techniques des constructeurs. Les puissances indiquées sont des valeurs maximales annoncées, sans parcimonie (« sparsity ») ; les performances réelles dépendent du modèle, du logiciel et de la configuration.
Quel serveur IA pour votre entreprise ?
Dites-nous ce que vous voulez automatiser : nous vous conseillons le matériel juste nécessaire, en local et sans que vos données quittent vos locaux. Laissez-nous un message ou appelez-nous.
- Localisation1 bis place Raymond Poincaré
40000 Mont-de-Marsan - Appelez-nous+33 5 58 44 36 84
Du lundi au samedi, 9h - 19h